
云端大模型,比如 Claude 和 ChatGPT,回答确实利索。简单讲,您的提示词是在别人的服务器上算的。本地大模型把这件事留在自己电脑上,隐私更好管。代价也直接:机器不够强,就只能跑小模型;小模型装不下那么多知识,不知道的时候又不太肯说“我不知道”。
这篇文章讲一个具体办法:不把整份维基塞进模型,而是在本机放一份离线维基,让模型要用事实时再去查。原稿作者用 Kiwix Wiki MCP Server 在旧电脑上试过。小编对照该项目说明和 Kiwix 的打包方式,把能照着做的步骤和边界写在下面。
硬件先把本地大模型卡住
别指望旧笔记本跑出云端那种效果
您大概已经感觉到,电脑和手机这段时间都不便宜。原稿把内存涨价说得很直白:做云端模型的数据中心在大量买显卡,内存厂把产能转向显卡用的高带宽内存,留给普通用户的就少了。价格每天都在变,这里不报具体数字。
自己跑模型,碰到的是同一类限制。要接近云端那种能力,通常得有足够的内存,再加一块还行的显卡。机器普通,也能跑,但只能选小得多的模型。小,不等于没用,只是别拿它当 ChatGPT 的本地版。
内存够不够,往往比峰值速度更先卡住人。这一头小编整理过骁龙笔记本和 RTX Spark 的对比,写在跑本地大模型,为什么有人更愿意先看骁龙笔记本。选权重之前,也先分清开放权重和真正开源,那篇在别被“开源模型”四个字带跑。
小模型能跑,知识库却小很多
不知道的事,它往往会编圆
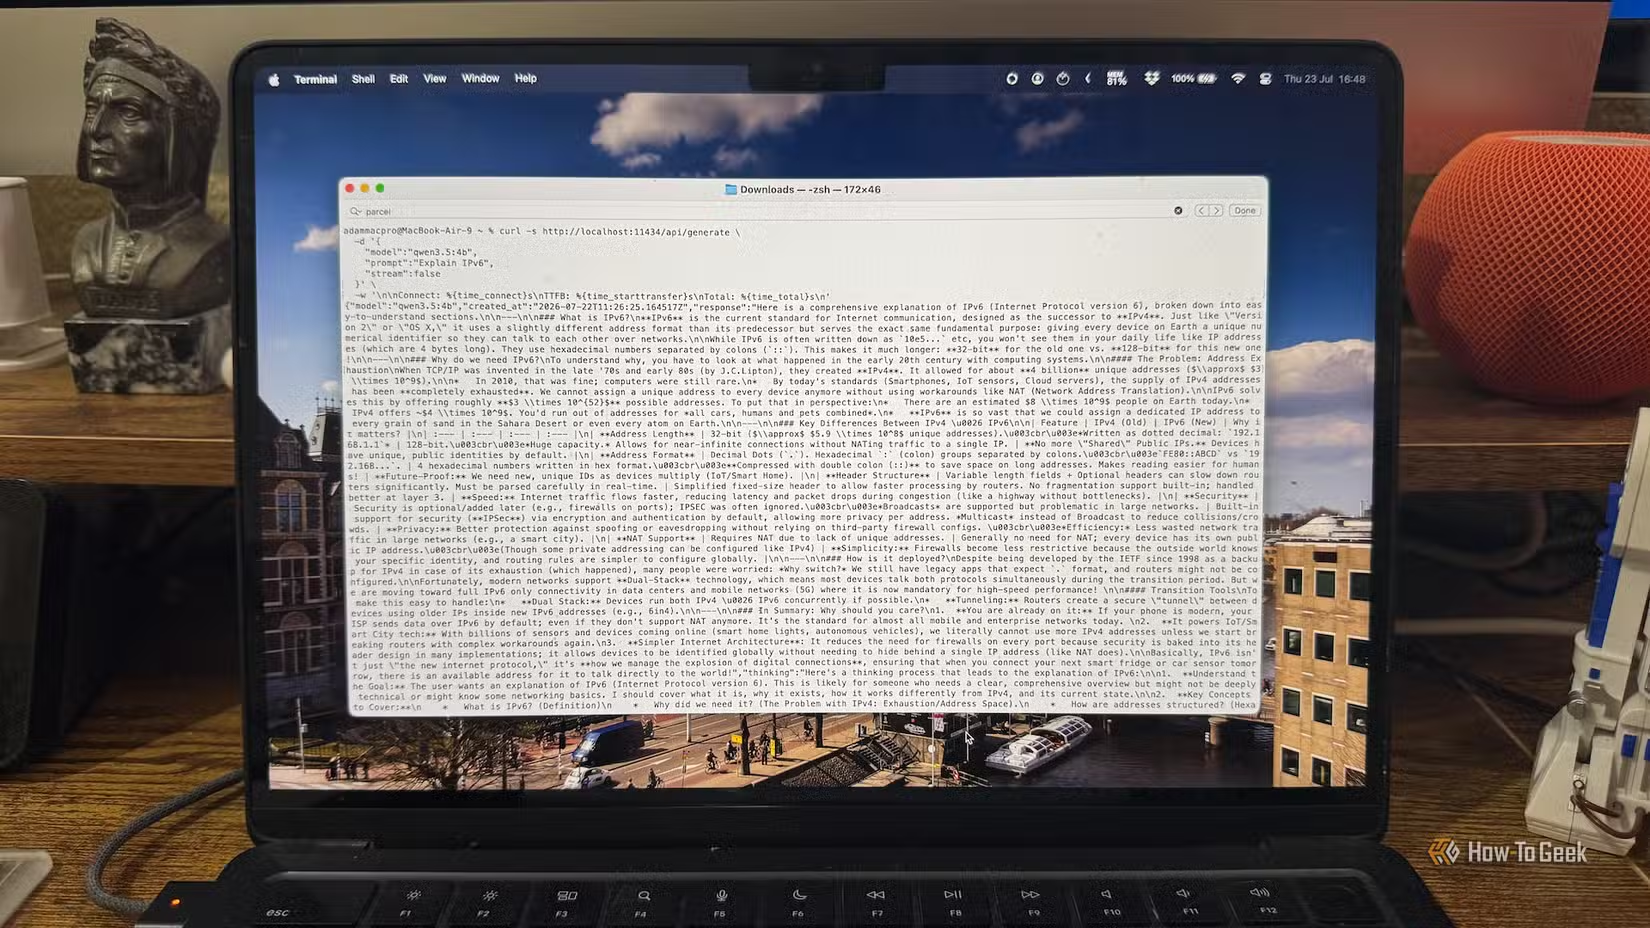
小模型做摘要、改句子、按固定格式输出,常常够用。它弱在两头:复杂推理,还有冷门事实。法国首都、鸡蛋怎么煮,它多半知道。Home Assistant 是谁做的,就不一定在它的参数里。
更麻烦的是,它不擅长承认自己不知道。缺知识的时候,会把听起来很像那么回事的句子说完整。您要是本来就不知道答案,这种编造和正确回答几乎一样像样。拿它查事实,这点得先记住。
把离线维基接到本地大模型上
资料放在您自己的电脑里,要用时再查
想看带完整实测数据的版本,可以读用离线维基百科给本地大模型补知识,老电脑也能答得更准。Kiwix 是一个免费的离线阅读工具,能在自己电脑上打开整份维基,不用联网。Kiwix Wiki MCP Server 做的事很窄:用模型上下文协议(MCP,简单讲就是一套让模型调用外部工具的接口)把 Kiwix 和模型接上,让模型可以搜索、读取这些离线页面。
资料放在 ZIM 文件里。ZIM 是为离线网页准备的压缩包,维基、古登堡计划的一些书库、iFixit 维修指南、Stack Exchange,都可以是这种文件。文件在您的硬盘上。模型并不把它们背下来,只是在回答时把相关段落拉过来。
我们查了这个项目的说明。它假定本机已经有一个 Kiwix 服务在跑,默认连到本机的 8080 端口,地址可以改。交给模型的工具主要是三个:搜索条目、按地址取正文、列出当前有哪些资料库。Ollama 负责把模型跑起来,它自己不会去翻维基。您用的那个聊天客户端,得同时连得上 Ollama 和这个 MCP 服务。
硬盘先按这个量来留
我们查公开的 Kiwix 打包说明时看到,英文维基不带图的整包常在 50GB 上下,带图的完整包往往超过 100GB。还有更小的专题包。体积以您下载那天 library.kiwix.org 上的数字为准,打包日期一变,文件大小就会变。
| 资料 | 大概要多大 | 适合谁 |
|---|---|---|
| 专题小包,比如医学、气候 | 几百 MB 到一两 GB | 先试通路径 |
| 英文维基,精简文本 | 十来 GB 这一档 | 硬盘紧,又想覆盖常识 |
| 英文维基,纯文本整包 | 大约 50GB | 原稿那次实测用的就是这种 |
| 英文维基,文字加图片 | 往往超过 100GB | 硬盘宽裕再考虑 |
一台旧电脑上的对照
不接维基,4B 模型对了不到一半
原稿作者的机器是一台十多年的 Dell OptiPlex:16GB 内存,沠有独显。模型是 Ollama 里的 Qwen 3.5 4B。他准备了 13 道常识题,先让模型只靠自己答。
13 道里对了 4 道。错的那些说得很肯定。问《黄蜂工厂》谁写的,它答 Iain Sinclair,1983 年。实际是 Iain Banks,1984 年。问 Home Assistant 的创始人,它答 Philipp “Phils” Hausmann。实际是 Paulus Schoutsen。
接上纯文本英文维基之后,对的明显变多
他放上英文维基的纯文本包,大约 50GB,同一批问题再问一次。这次对了 11 道,1 道只对了一部分,还有 1 道它拒绝回答:2026 年六国橄榄球锦标赛的冠军。它说自己认定的“今年”是 2024。这 13 条回答里,没有再出现凭空编出来的事实,用的是维基服务拉回来的内容。
慢也是明摆着的。只靠模型,大约 9 秒;要先查资料再写,大约 2 分钟。换来的是少瞎编,不是更快。这是一台旧电脑、一个 4B 模型、13 道题的结果,不是所有模型的通用榜单。
| 对比 | 只靠模型自己 | 接上离线维基 |
|---|---|---|
| 13 道常识题 | 对 4 道 | 对 11 道,1 道部分对,1 道拒答 |
| 错的时候 | 会把错的说得很像真的 | 这次没有凭空编造,用的是条目内容 |
| 一次回答 | 大约 9 秒 | 大约 2 分钟 |
| 机器 | 同一台:十多年的 OptiPlex,16GB 内存,无独显 | |
想让小模型少瞎编,就给它能查的资料
推理能力不会因为接了维基就变成大模型。它仍然可能读错段落、抓错条目,维基自己也有过时和写错的页面。您拿它做决定之前,重要的事实还是得点开条目看一眼。
照着做的顺序
- 先到 Kiwix 官方库下一个小的 ZIM。硬盘紧就别一上来下带图的完整英文维基。
- 装上 kiwix-tools。Linux 上常用软件源里有,macOS 可以用 Homebrew,也可以从 kiwix.org 的下载页拿安装包。
- 用 kiwix-serve 把这个文件在本机打开。项目说明里的例子是 8080 端口。浏览器能打开页面,再往下走。
- 装上 Kiwix Wiki MCP Server,按它的说明执行依赖安装和构建,确认它指向刚才那个本机地址。
- 在支持 MCP 的客户端里启用这个服务,同时让客户端去调用您已经用 Ollama 跑起来的模型。
- 先问一个您自己知道答案的冷门问题。看它是在引用条目,还是仍然在凭空说。
中文维基也有 ZIM。原稿那次测的是英文纯文本包。您要是只放了英文包,模型查到的原文就是英文,再由它翻成中文。翻译会多一层出错的机会,重要名词请对着原文看。
常见问题(FAQ)
我电脑内存不大,是不是就别跑本地模型了?
不是。16GB、沠有独显的旧电脑,原稿里就跑起了 4B 模型。别期待它跟云端大模型一样能推理。查事实这件事,可以把资料放在硬盘上,不必全塞进内存。
接上维基以后,小模型还会瞎编吗?
会少,不会消失。原稿那次,接上之后沠有再编造事实,但它仍然可能抓错条目,或把条目读偏。维基写错了,它也会跟着错。
英文维基纯文本包,硬盘大概要留多少?
大约 50GB,再留一点解压和系统用的空间。带图片的完整包往往超过 100GB。先下专题小包试,比一下子占满硬盘更稳妥。
为什么接上以后回答变慢了?
因为多了搜索和读文章。原稿里从大约 9 秒变成大约 2 分钟。旧电脑、大文件,都会把这段等待拉长。查事实可以等;改一句话、写个提纲,就没必要每次都去翻维基。
这和把维基训进模型里,有什么不一样?
训进去,知识写死在权重里,更新就得重新训。这种接法是现查现用,换一份更新的 ZIM 就行,模型本身不用动。它也占硬盘,而不是把内存要求再提一大截。
写在最后
本地大模型的短板,很多时候不是它不会说话,而是它沠把事实装进去。给小模型一份能查的离线维基,比换一台更贵的电脑更先解决“乱编”这件事。推理仍然有限,回答也会变慢。您要的如果是在自己电脑上查得准一点,这条路值得先用小包试一次。如果想看本地模型接管家里暖气的实验,可以读用本地大模型管暖气一周,能不能赢过Nest和Ecobee?。